Automation Log
자린고비 자동화 붙이기
팀원마다 작업 시간이 달라서 이슈가 생겨도 바로 처리하지 못할 때가 있었다. 그래서 이슈가 생기면 더 신속하고 편하게, 그치만 안전하게 처리하고 싶었다.
그래서 만들고 싶은 건 이거였다.
팀원이 슬랙에 /error-notice (이슈 내용) 을 입력하면, 클로드가 아래 작업을 모두 진행하는 것.
이슈 접수 → 코드 분석 → 버그 픽스 → PR 생성 → 이슈 분석 & 수정 결과와 PR 생성을 슬랙으로 공유
현재 운영 중인 서버는 EC2 t3.micro 한 대 (vCPU 2개, RAM 1GB)이지만,
위 자동화를 위해 바로 서버를 키우거나, 유료 결제하는 것보단 기존의 상황을 최대로 활용하여 최소한의 비용으로 진행하고자 했다.
아래 내용은, 비용 추가 없이 자동화를 도입하여 팀 생산성을 향상시킨 과정에 대한 내용이다.
비용 ①: 서버 자원 — 무거운 일은 서버 밖으로
제일 먼저 정한 건 claude -p(비대화형 모드)를 어디서 돌릴 것인가였다.
- 운영 서버에서 직접 → 탈락.
- 1GB 서버에서 클로드 + 저장소 클론 + gradle 빌드를 같이 돌리면 앱이랑 메모리 싸움 난다.
- GitHub Actions에서 → 필요할 때만 리눅스 러너가 켜지고 끝나면 사라진다.
- 우리 서버는 손도 안 댄다.
2번 GitHub Actions로 갔다. 그래서 서버가 하는 일은 딱 둘로 쪼그라들었다.
① 팀원  /error-notice (이슈 내용)
     │
     ▼  POST /slack/error-notice
② [EC2·Spring] 서명 검증 → 3초 안에 "접수했어요" 회신 → GitHub 깨우기
     │           (여기까지가 서버 일의 전부. CPU 거의 안 씀)
     ▼  repository_dispatch
③ [GitHub Actions] 코드 분석 → 이슈면 수정 → 컴파일 검증 → PR 생성
     │             (클로드 실행·빌드는 전부 여기서)
     ▼  POST /slack/error-notice/callback
④ [EC2·Spring] 슬랙으로 결과 알림
접수해서 GitHub 깨우기, 결과 나오면 알림. 서버는 이 둘만 한다.
무거운 건 전부 Actions 러너에서 돈다. 우리 1GB에 얹히는 부하는 사실상 0이다.
비용 ②: 금전 — GitHub Actions 무료 한도
현재 이 서비스 레포는 private이기 때문에, GitHub Actions가 마냥 무료는 아니다. private 레포는 실행 시간에 따라 과금된다.
(public은 무료지만 왠지 private을 유지하고 싶은...ㅎㅎ)
그래서 실제로 확인했다.
Free 조직 private 레포 = 월 2,000분 무료
누적 사용 50분 시점 → grossAmount 0.3 / discountAmount 0.3 / netAmount 0.0
건당 5~15분 잡아도 월 130건까지 공짜다.
여기서 짚고 갈 게 있다. 이 "무료"는 무한 공짜가 아니라 매달 정해진 양(2,000분)까지 GitHub이 대신 내주는 것이다.
핸드폰 통신사 요금제에 데이터 기본제공량이 있고, 그 안에서 쓰는 느낌?!
아무튼 그 기본제공량 내에서 사용하니 청구가 0인 거지, 컴퓨팅이 공짜라서가 아니다.
한도를 넘으면?
GitHub 기본 지출 한도가 $0이라 자동 과금되지 않고 그냥 실행이 멈춘다. 신용카드를 등록하고 한도를 직접 올리지 않는 한 청구서가 날아올 일이 없다.
즉 "모르는 새 돈이 새는" 시나리오 자체가 막혀 있다.
비용 ③: Claude — 기존 구독 재활용, API 결제 0
클로드를 Actions에서 돌리려면 인증이 필요하다. 여기서 Anthropic API 키를 새로 발급받아 결제하면, 쓰는 만큼 토큰 요금이 붙는다.
claude setup-token 한 번 돌리면 나오는 토큰을 GitHub Secret에 넣으면, 이미 쓰고 있는 Claude Pro 구독을 그대로 재활용한다. 종량 API 요금 0원.
대신 이건 내 Pro 사용량을 나눠 쓰는 구조라, 봇이 한도를 다 태우면 정작 내가 작업할 때 걸린다. 그래서 하루 처리 상한(5건) 과 건당 타임아웃(20분) 을 걸었다.
이건 내 토큰 사용량을 아끼는 안전장치다.
비용 ④: 인프라 — 아무것도 새로 만들지 않기
테이블조차도 추가하지 않았다.
근데 아무 데도 저장을 안 했으면, 중간에 뭐가 잘못되면 어떻게 될까?
상태를 DB에 안 넣었다는 건, "기억하는 곳이 없다"는 뜻이다. 그럼 이런 게 걱정된다.
☠️ 이슈 접수는 됐는데 서버가 죽으면?
경우를 나눠야 한다.
- 접수하는 순간에 죽으면
- 3초 서버 응답 자체가 안 나가서 슬랙에 실패로 뜬다. 아직 아무것도 시작 안 한 상태라, 팀원이 다시 입력하면 된다.
- GitHub을 깨운 뒤(진행 중)에 죽으면
- 여기서부턴 서버랑 무관하다. 분석도 PR 생성도 전부 Actions에서 도니까, 서버가 죽든 말든 PR은 정상적으로 만들어진다.
- Actions가 결과를 서버로 콜백하는 순간에 서버가 죽어 있으면
- 슬랙 결과 알림만 유실된다. 재시도할 근거(상태)를 아무 데도 저장 안 했으니까.
- 하지만 무중단 배포(블루-그린)라 서버가 통째로 죽는 일 자체가 드물고, 유실돼도 PR은 GitHub에 멀쩡히 남아 있어서 Actions 탭이나 PR 목록에서 그대로 확인된다.
→ 👍🏻 알림 한 번 놓치는 것과 DB 스키마를 늘리는 것, 이 서비스에선 전자가 더 적절하다고 판단했다.
⌛️ 작업이 너무 오래 걸리면?
서버는 3초 안에 응답하고 이미 손 뗐다. 그래서 클로드 분석이 5분이 걸리든 15분이 걸리든 서버는 아무것도 붙잡고 있지 않는다.
Actions 쪽엔 건당 20분 타임아웃을 걸어놔서, 넘으면 워크플로가 강제 종료된다. 그리고 결과 회신 스텝을 if: always()로 둬서 타임아웃이든 실패든 "확인 도중 문제가 생겼어요" 알림은 나간다. 조용히 사라지지 않는다.
동시에 여러 건이 들어오면?
concurrency 설정으로 한 번에 하나씩 순차 처리한다. 뒤 요청들은 앞 작업이 끝날 때까지 Actions 큐에서 기다린다.
concurrency:
  group: error-notice
  cancel-in-progress: false   # 진행 중인 걸 죽이지 않고 끝날 때까지 기다림
실제 테스트
실제 존재하는 사소한 이슈를 찾아 테스트했다.
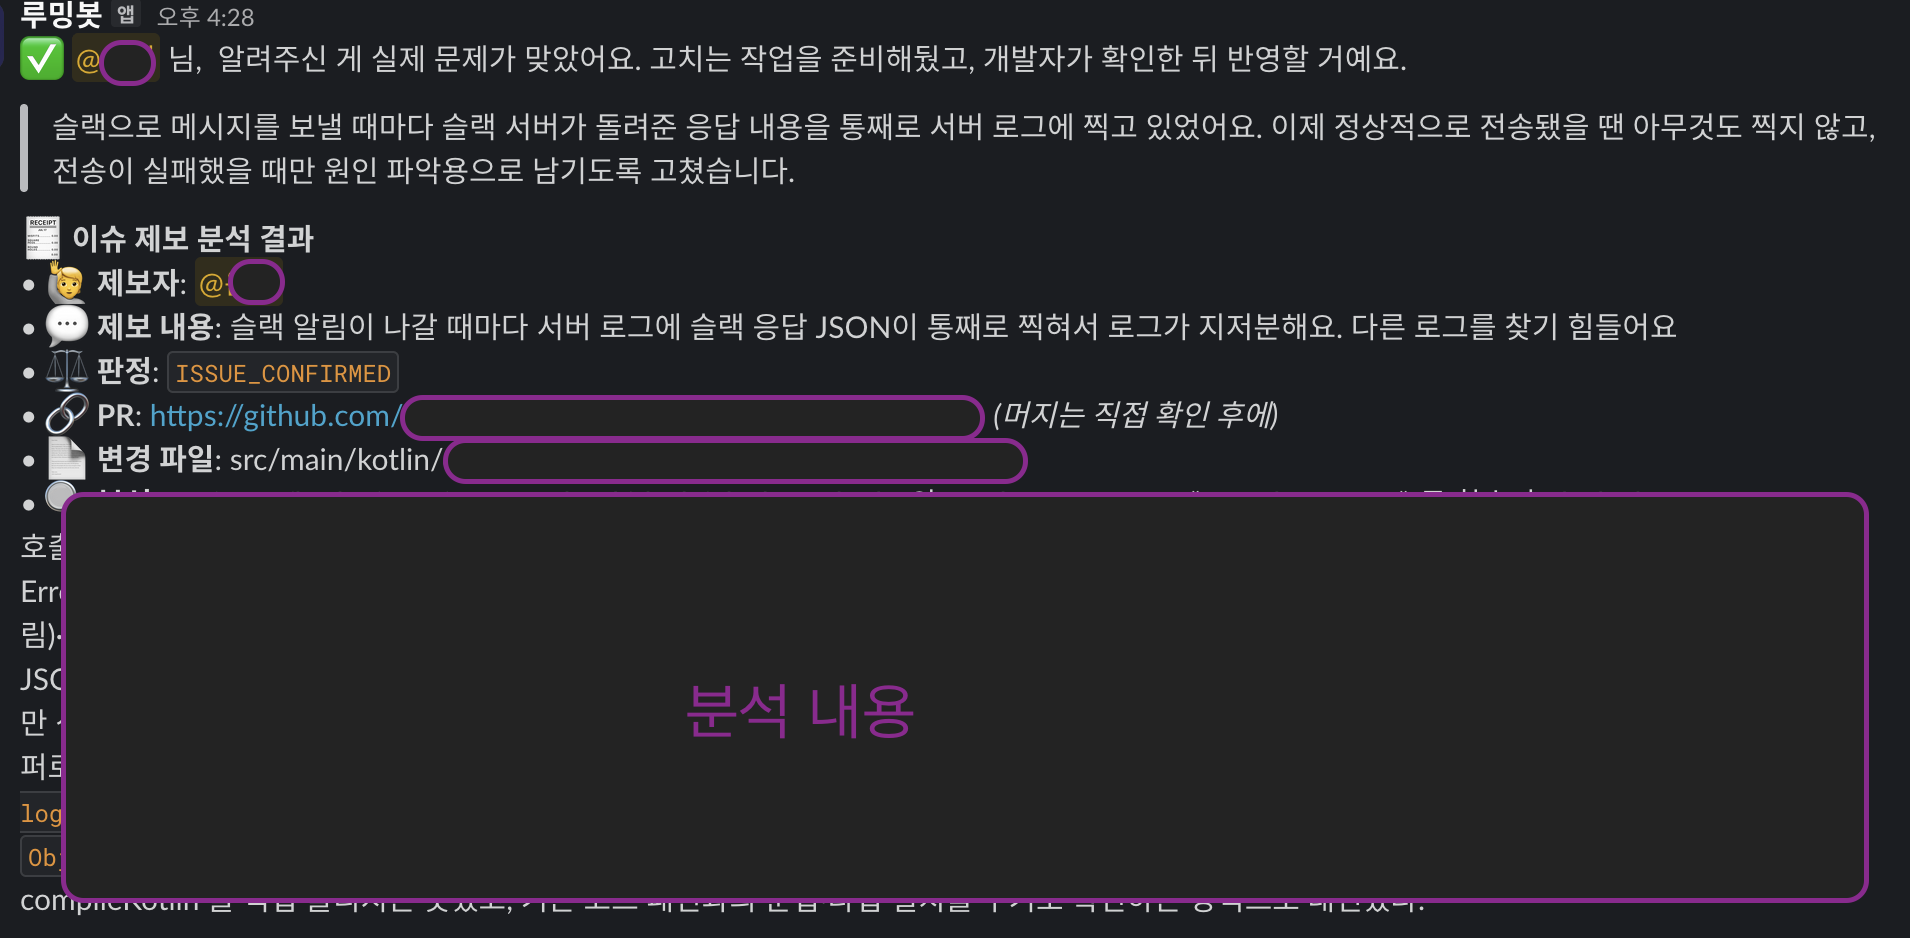
/error-notice 슬랙 알림이 나갈 때마다 서버 로그에 슬랙 응답 JSON이 통째로 찍혀서 로그가 지저분해요
실제로 SlackSender가 슬랙 응답을 println으로 그냥 뱉고 있었고, 클로드가 이걸 찾아서 고친 PR을 올렸다.
기존 코드에 있던 패턴을 그대로 따라 써서 수정했고, 정상적으로 PR 올린 후 슬랙 알림까지 확인했다.
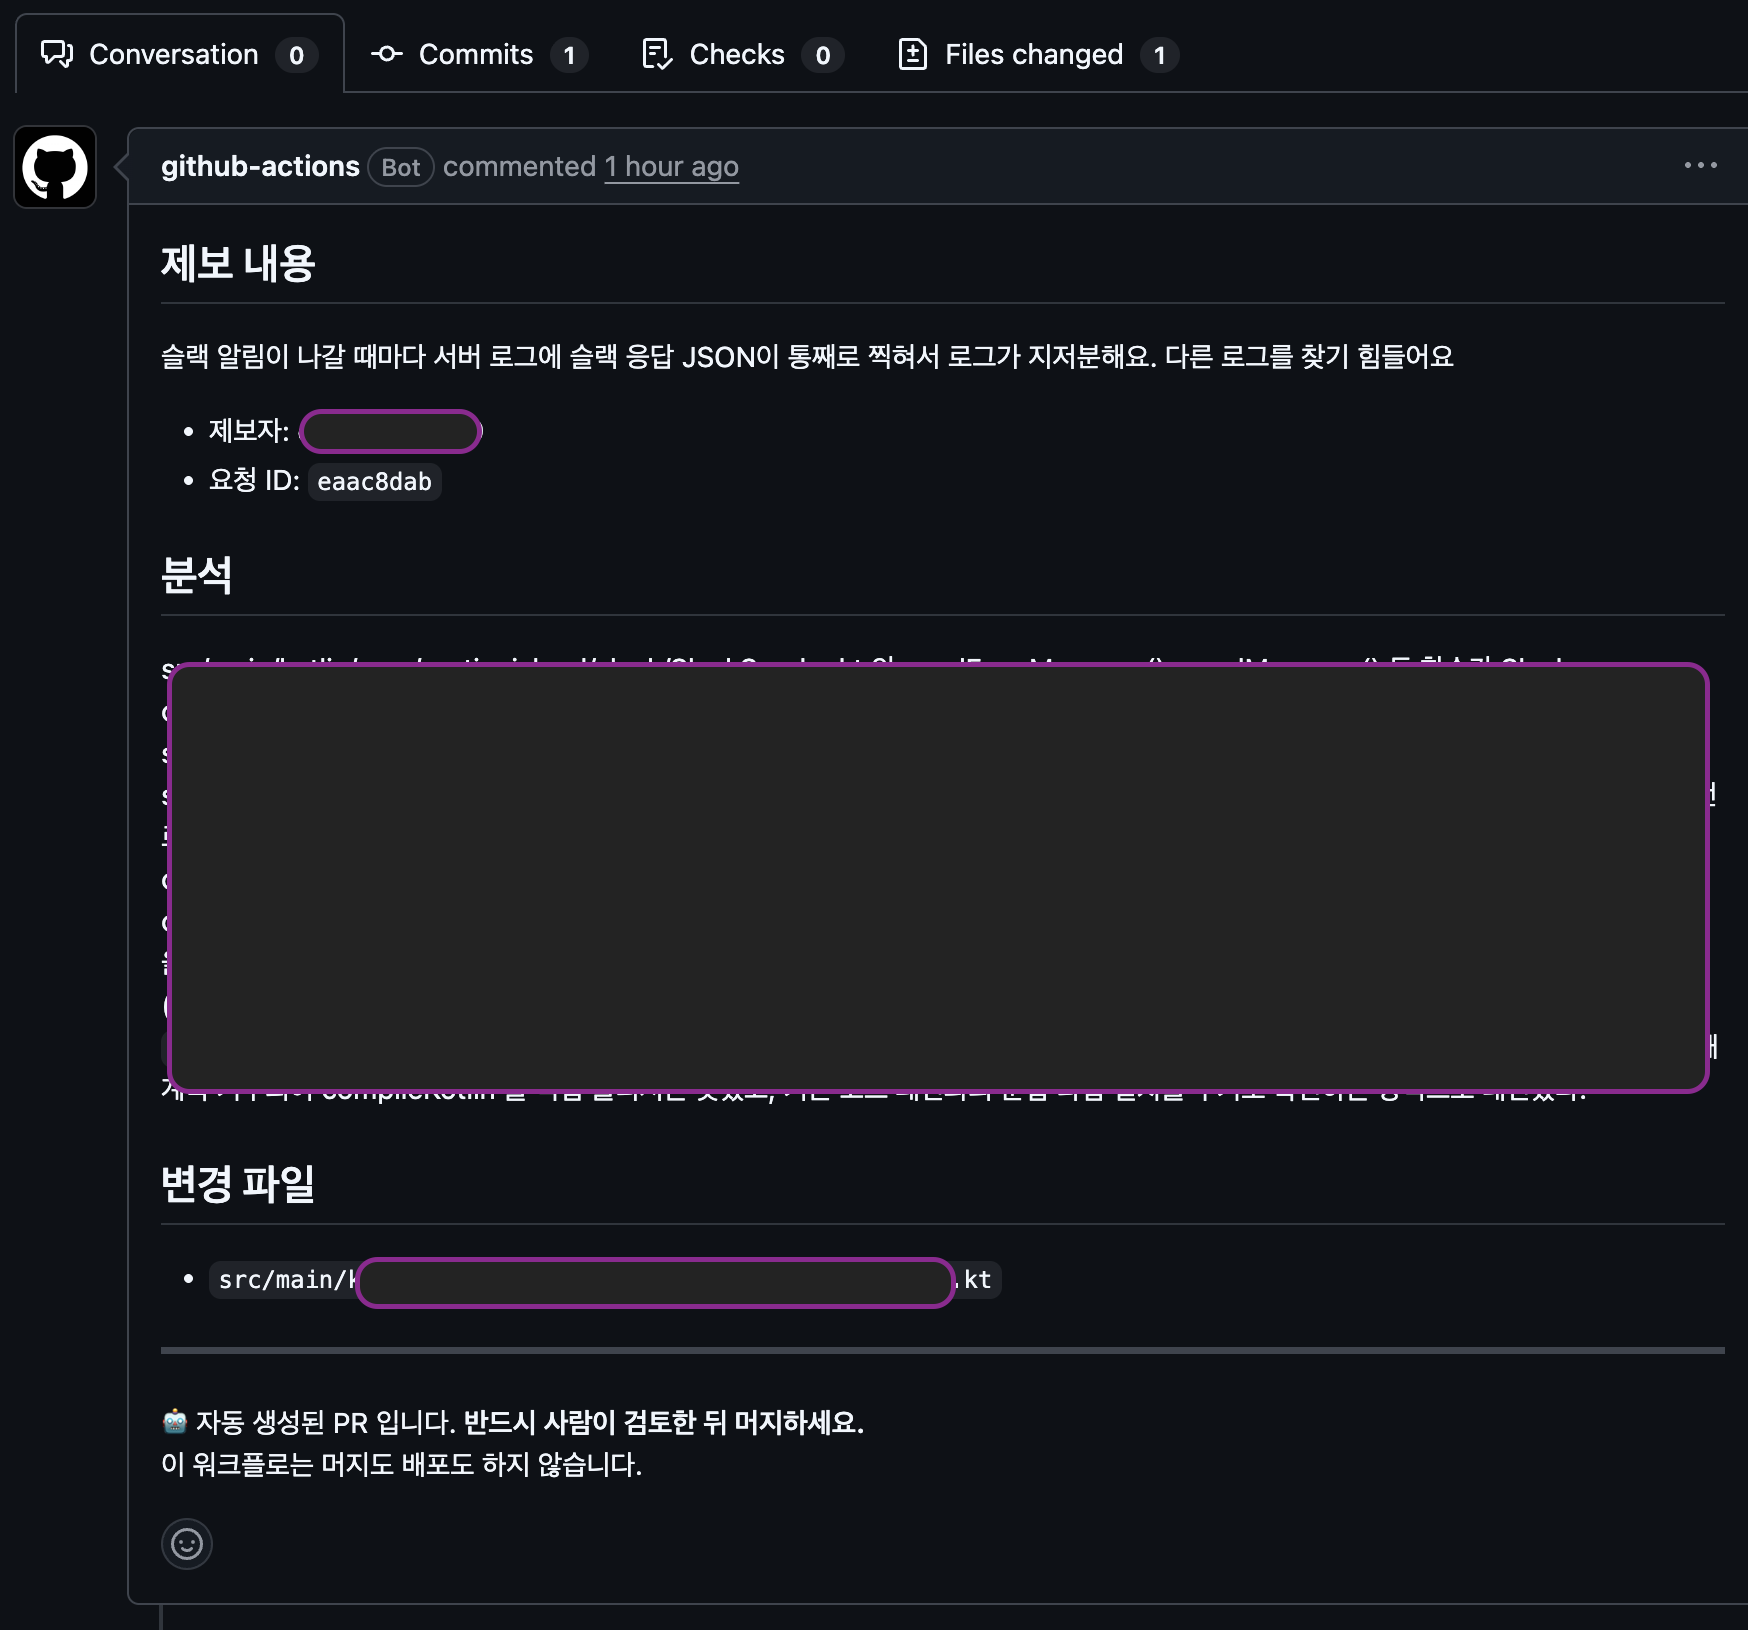
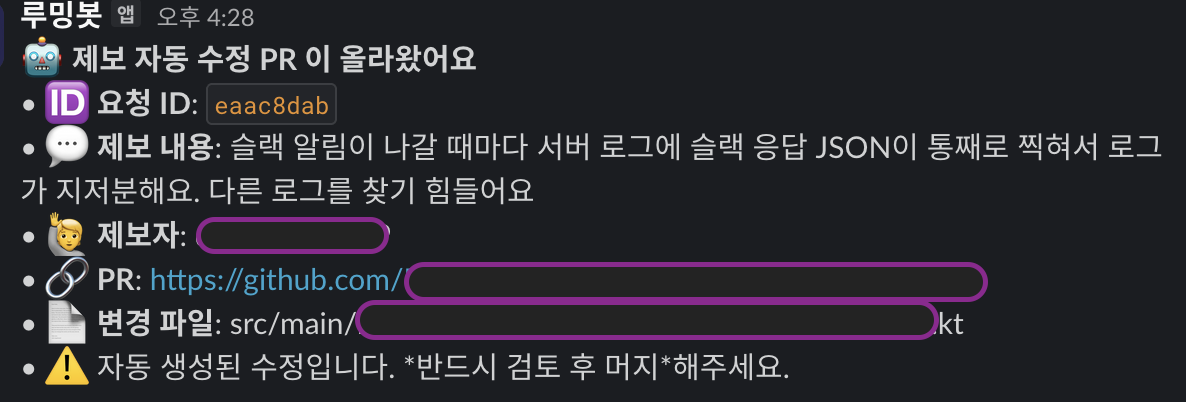
위 두 이미지는 서버 담당자를 위한 화면이고, 아래는 제보자가 확인하는 화면이다.
비용 결산
| 항목 | 비용 |
|---|---|
| GitHub Actions 실행 (월 2,000분 무료) | $0.00 (실측) |
| 초과 시 | 자동 과금 없음 — 그냥 멈춤 |
| Claude (기존 Pro 구독 재활용) | 종량 API 결제 0원 |
| 서버 자원 (무거운 일은 Actions로) | 1GB 서버 부하 ≈ 0 |
| 상시 실행 서버 | 불필요 |
실제로 비용이 나가는 건 하나도 없다. 아끼려고 통제한 건 내 Claude Pro 사용량뿐이다. 그것도 일일 상한으로 막아뒀다.
마무리
물론! 모든 상황에서 이 방법이 적절한 건 아니다.
우리는 팀원이 적고, 이슈 빈도가 낮다는 전제가 깔려있다.
앞에서 말했듯 이 방식이 무조건 0원!! 이라는 건 절대 아니고, 기본 제공량을 최대한 활용한 것뿐이다.
평소 이것저것 붙이는 것보다 현재 상황을 최대한 고려한 방식을 택하는 걸 우선시하여 적용해봤는데, 상황이 바뀌거나 문제가 발생한다면 또 다른 방식을 탐색해볼 예정이다~~